
アプリ&拡張機能
DifyとOllamaでオープンなRAG型チャットボットを構築してみた。

ざわ
公開日:2024/06/03
はじめに
AIを活用して業務を効率化したいですよね。
ただ、外部のサービスを用いると企業秘密の流出が懸念されますので、なるべく独自環境で動かしたいものです。
そこで、オープンなアプリケーションと言語モデルを使用してローカル環境で動くRAG型のチャットボットを構築してみました。
RAG型チャットボットというのは、言語モデルにナレッジを与え、検索させるようなチャットボットです。
構築例を記載しますが実践にあたっては自己責任にてお願いします。
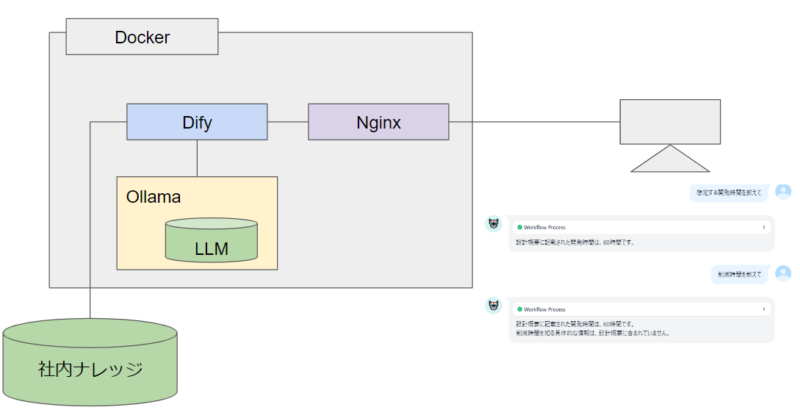
構築概要図
構築
DifyとOllamaの導入
Difyとは
Difyはローコードでのチャットボットの作成ができるオープンソースのアプリケーションです。
言語モデルは持っていませんので外部の言語モデルをAPI経由で使用します。
https://github.com/langgenius/dify
Ollamaとは
Ollamaは、LLMをローカル環境で実行しAPIを提供してくれるオープンソースのアプリケーションです。
https://github.com/ollama/ollama
導入
DifyとOllamaをDocker環境にて導入していきます。
同一サービス内に書いたほうがコンテナ間の通信が楽になるのでDifyのdocker-compose.yamlファイルの中にollamaの導入を記載しました。
ollamaはDockerFileを下記サイトを参考にdocker-composeのスタイルにしました。
# difyをクローン
git clone https://github.com/langgenius/dify.git


# Difyのdockder-composeファイルにollama分を追記する。
vim dify/docker/docker-compose.yaml

~~~~~~~~~~~~略(nginxブロックの次)~~~~~~~~~~~~
ollama:
  restart: always
  image: ollama/ollama
  container_name: ollama
  ports:
    - "11434:11434"
  volumes:
    - ollama:/root/.ollama

volumes:
  ollama:
~~~~~~~~~~~~略(networkブロックの前)~~~~~~~~~~~~

# 起動
docker-compose up -d
Difyにアクセス
ブラウザでlocalhostにアクセスしてDifyの管理者ユーザ登録画面が表示されればDifyの導入は完了です。
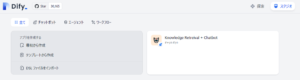
下記はDifyトップページです。
OllamaにてLLMの呼び出し
使用するLLM(大規模言語モデル)を呼び出します。
今回はGoogleのGemmaの7B版を使用しました。テキスト埋め込みモデルはnomic-embeded-textを使用しました。
# ollamaのコンテナに入る
docker exec -it ollama bash

# gemma:7bをプル
ollama pull gemma:7b

# テキスト埋め込みモデルもプル
ollama pull nomic-embed-text
DifyからOllamaへのAPI連携
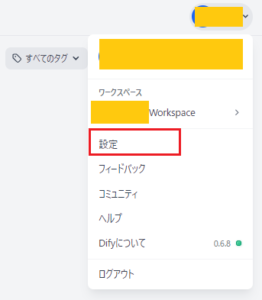
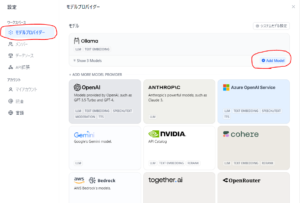
設定→モデルプロバイダーからollamaのAdd Modelをクリックします。
(Ollamaは初期状態だと画面下部のタイルにあります。)
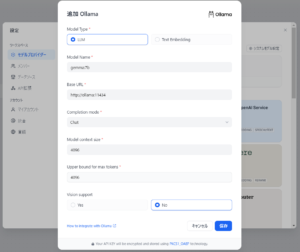
pullしたモデル名とollamaへの接続情報を下記のように記載します。
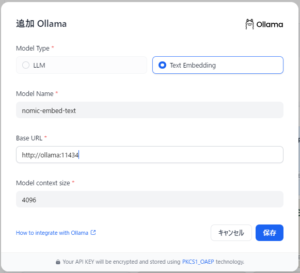
テキスト埋込モデルも同じく読み込みます。
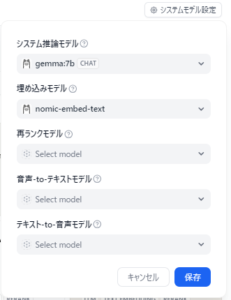
システムモデル設定
モデルプロバイダー画面上部の「システムモデル設定」をクリックして、システム推論モデルに先ほどpullしたモデルを選択します。
RAG型チャットボットの作成
ナレッジの登録
ナレッジから知識を作成をクリックします。
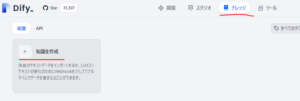
今回はmarkdownで書かれた下記のナレッジを取り込んでみます。
# 掲示板システムの概要
## 要件
- 記事を投稿することができる
- 投稿された記事に対して返信することができる。
- 返信は投稿された記事に関連付けて表示される。
- 返信に対して返信することはできない。
- 記事の投稿及び返信はログインしているユーザのみ可能。

## 開発時間
想定60H

## 効果

### 交流促進
気軽に投稿できるシステムにすることで従業員同士の交流が促進される。

### コミュニケーションコスト削減
掲示板システムを利用することで、ミーティングの開催を減らし、コミュニケーションにかかる時間を削減する。

一人当たりの想定削減時間:1時間/月
全社の想定削減時間:12時間/月
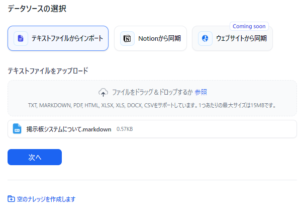
今回はデフォルトのまま取り込みます。
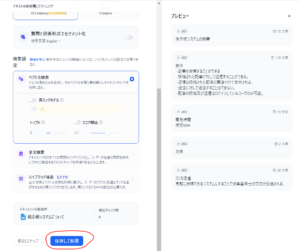
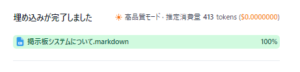
暫く待つと取り込みが完了します。
ワークフローの作成
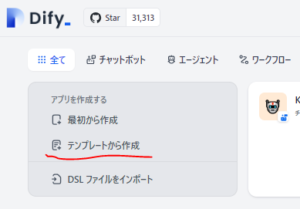
トップページにて「テンプレートから作成」をクリックします。
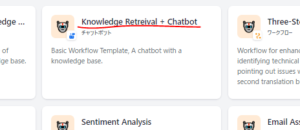
Knowledge Retreival + Chatbotを選び、名前をつけて作成します。
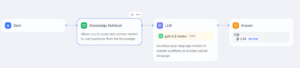
下記の基本ワークフローが展開されますので、細かい調整を加えていきます。
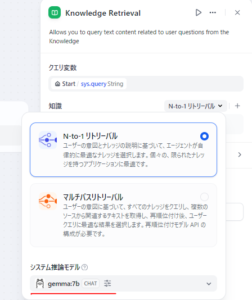
使用するナレッジの選択
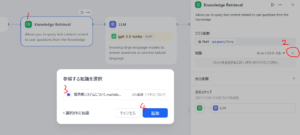
この際にN-to-1 リトリーバルのモデルも変更してください。
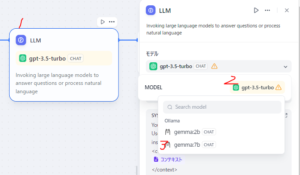
LLMを選択し、使用するモデルを設定します。
コンテキストにナレッジの結果を選択し、プロンプトを作成します。
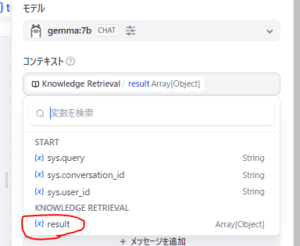

プロンプトは下記の通りとしました。
?あなたはシステムエンジニアです。設計概要を参照して顧客からの問い合わせに回答してください。
設計概要にない事柄については、現時点で答えることはできない旨をお伝え下さい。
# 設計概要 (コンテキスト)
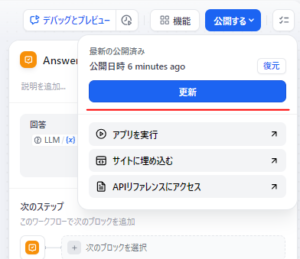
公開から更新ボタンを押します。続けて「アプリを実行」をクリックすることでチャットボットを起動できます。
チャットボットへの問い合わせ
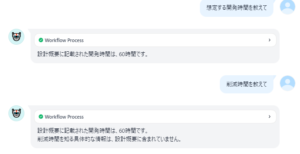
システムの概要を学習させたチャットボットへ質問を投げかけるとナレッジを参照して返事を返してくれますが、
渡されたナレッジにある情報に答えらず下記の画像のようになったりするので、精度を高めるには工夫が必要そうです。
まとめ
RAG型チャットボットを自社環境内にて構築してみました。
設計書などを読み込ませたチャットボットを作成することでIT部署への問い合わせ回数を減らせるかもしれません。
ただし、使用するモデルやパラメータ、ナレッジの蓄積方法などによって精度も変化すると予想できるので、引き続き研究を続けたいと思いました。
